
本土物种DNA条形码数据库构建
DNA条形码数据库构建方案
解决方案简介
本方案旨在为特定区域(如重点流域、自然保护区、省市行政区等)量身定制高精度、标准化的本土物种DNA条形码参考数据库。为满足不同项目的应用场景与预算需求,方案提供“标准版”与“高级版”两种构建模式:
模式一:标准数据库构建
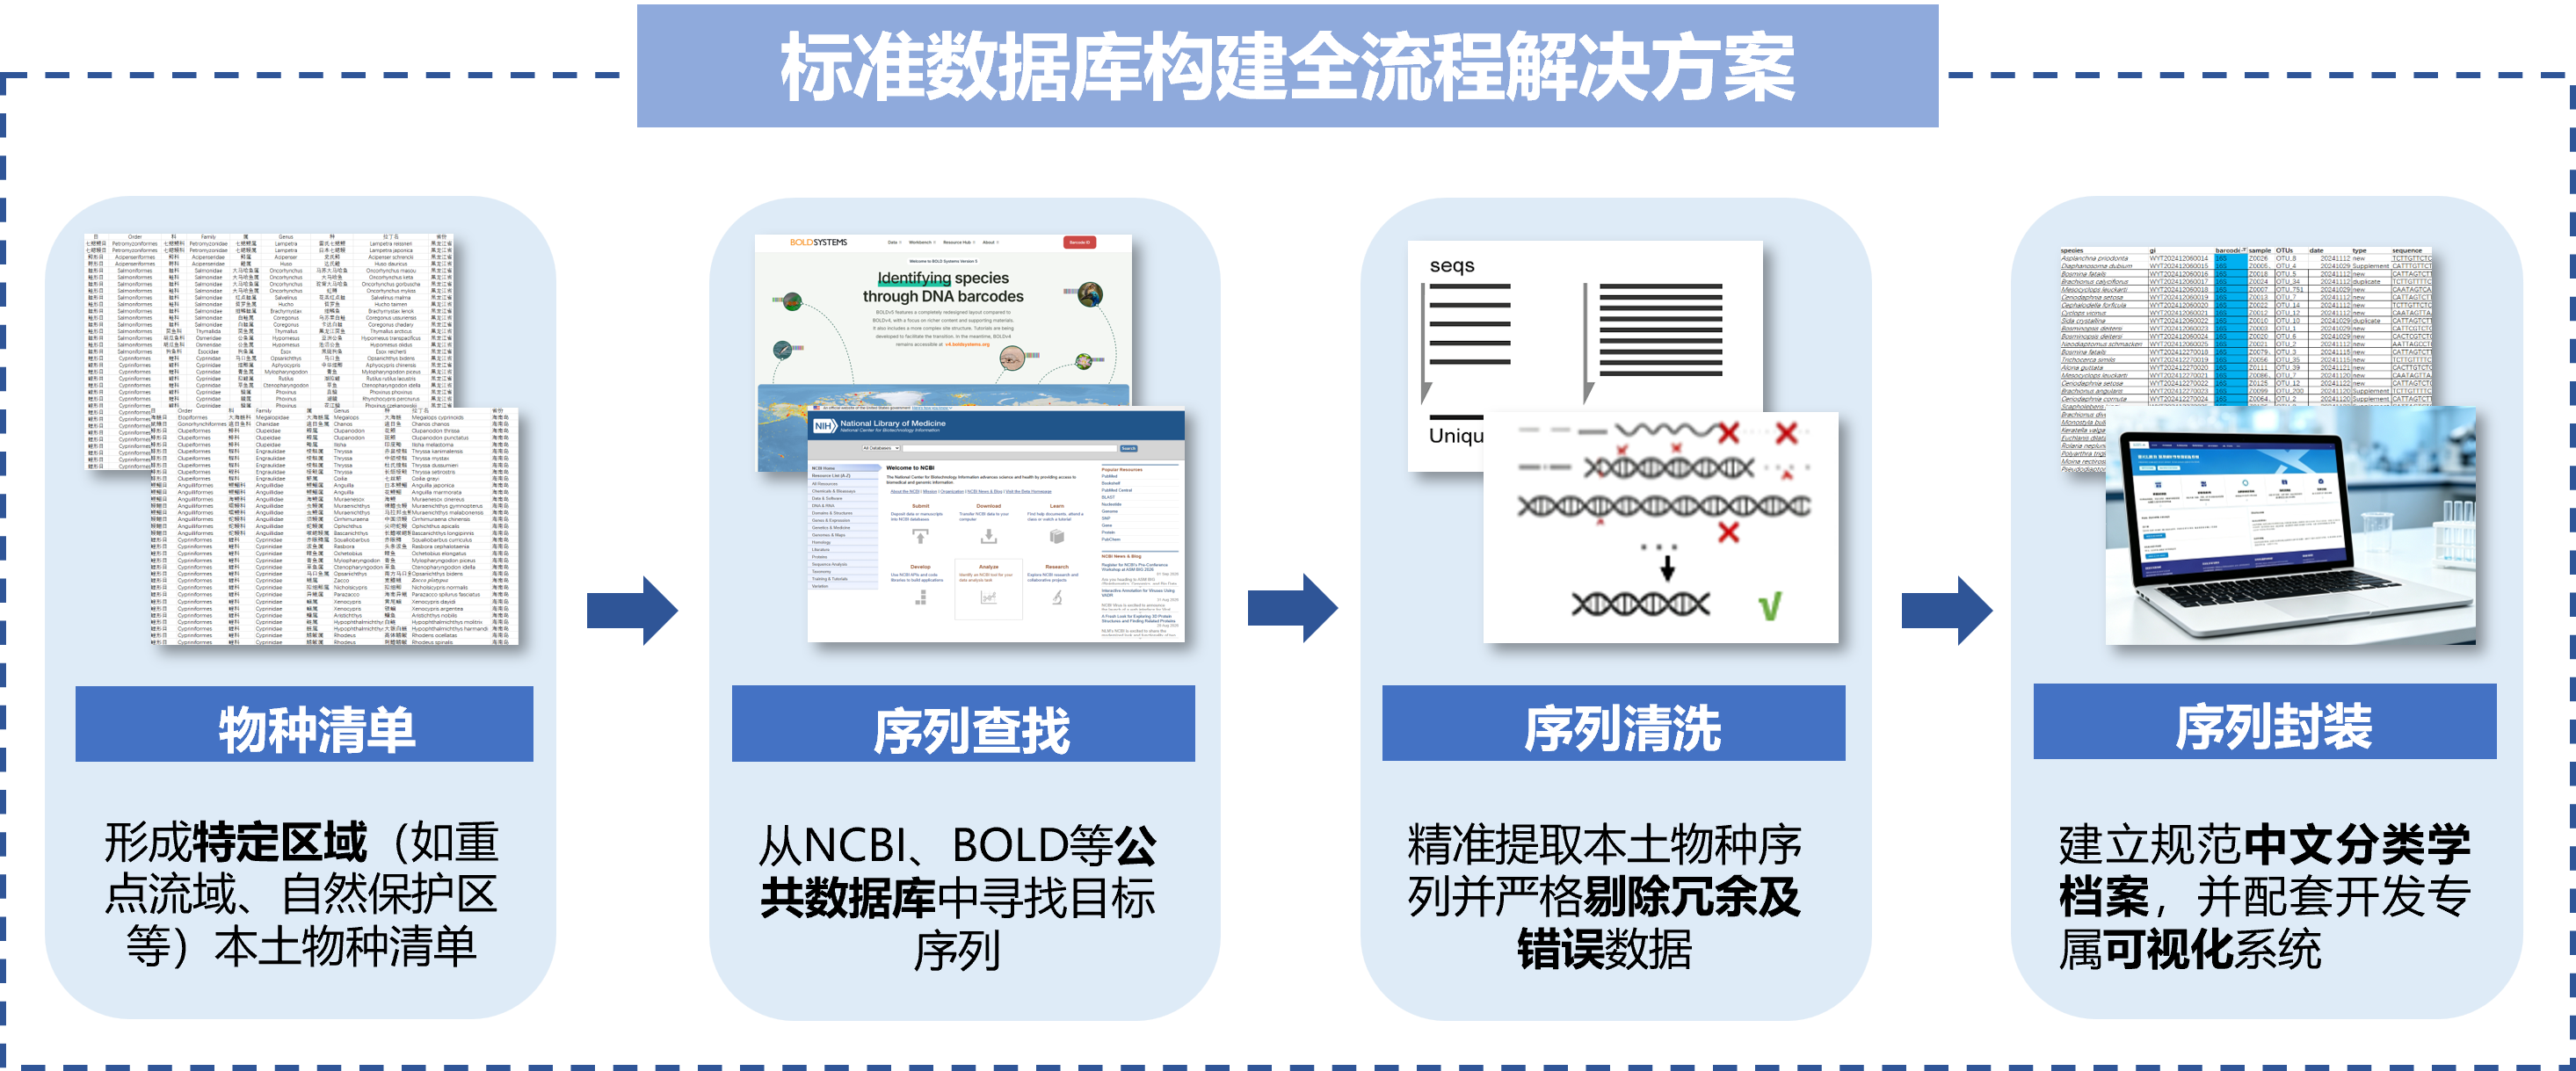
数据深度整合与优化依托海量公共数据,通过生物信息学手段打造开箱即用的本地化数据库。
数据清洗与甄别
依据本土物种清单,对NCBI、BOLD等公共数据库中的序列进行深度梳理,精准提取本土物种序列并严格剔除冗余及错误数据。
引物定制化处理
针对实际检测中使用的不同扩增引物,对数据库序列进行精准截长与再聚类,大幅提升后续比对的准确率。
系统化与汉化管理
建立规范、统一的中文分类学信息档案,并配套开发专属的“可视化数据库管理系统”。
交付即用
最终交付的数据库可直接、无缝应用于环境DNA(eDNA)及宏条形码数据的物种精准注释。
模式二:高级数据库构建
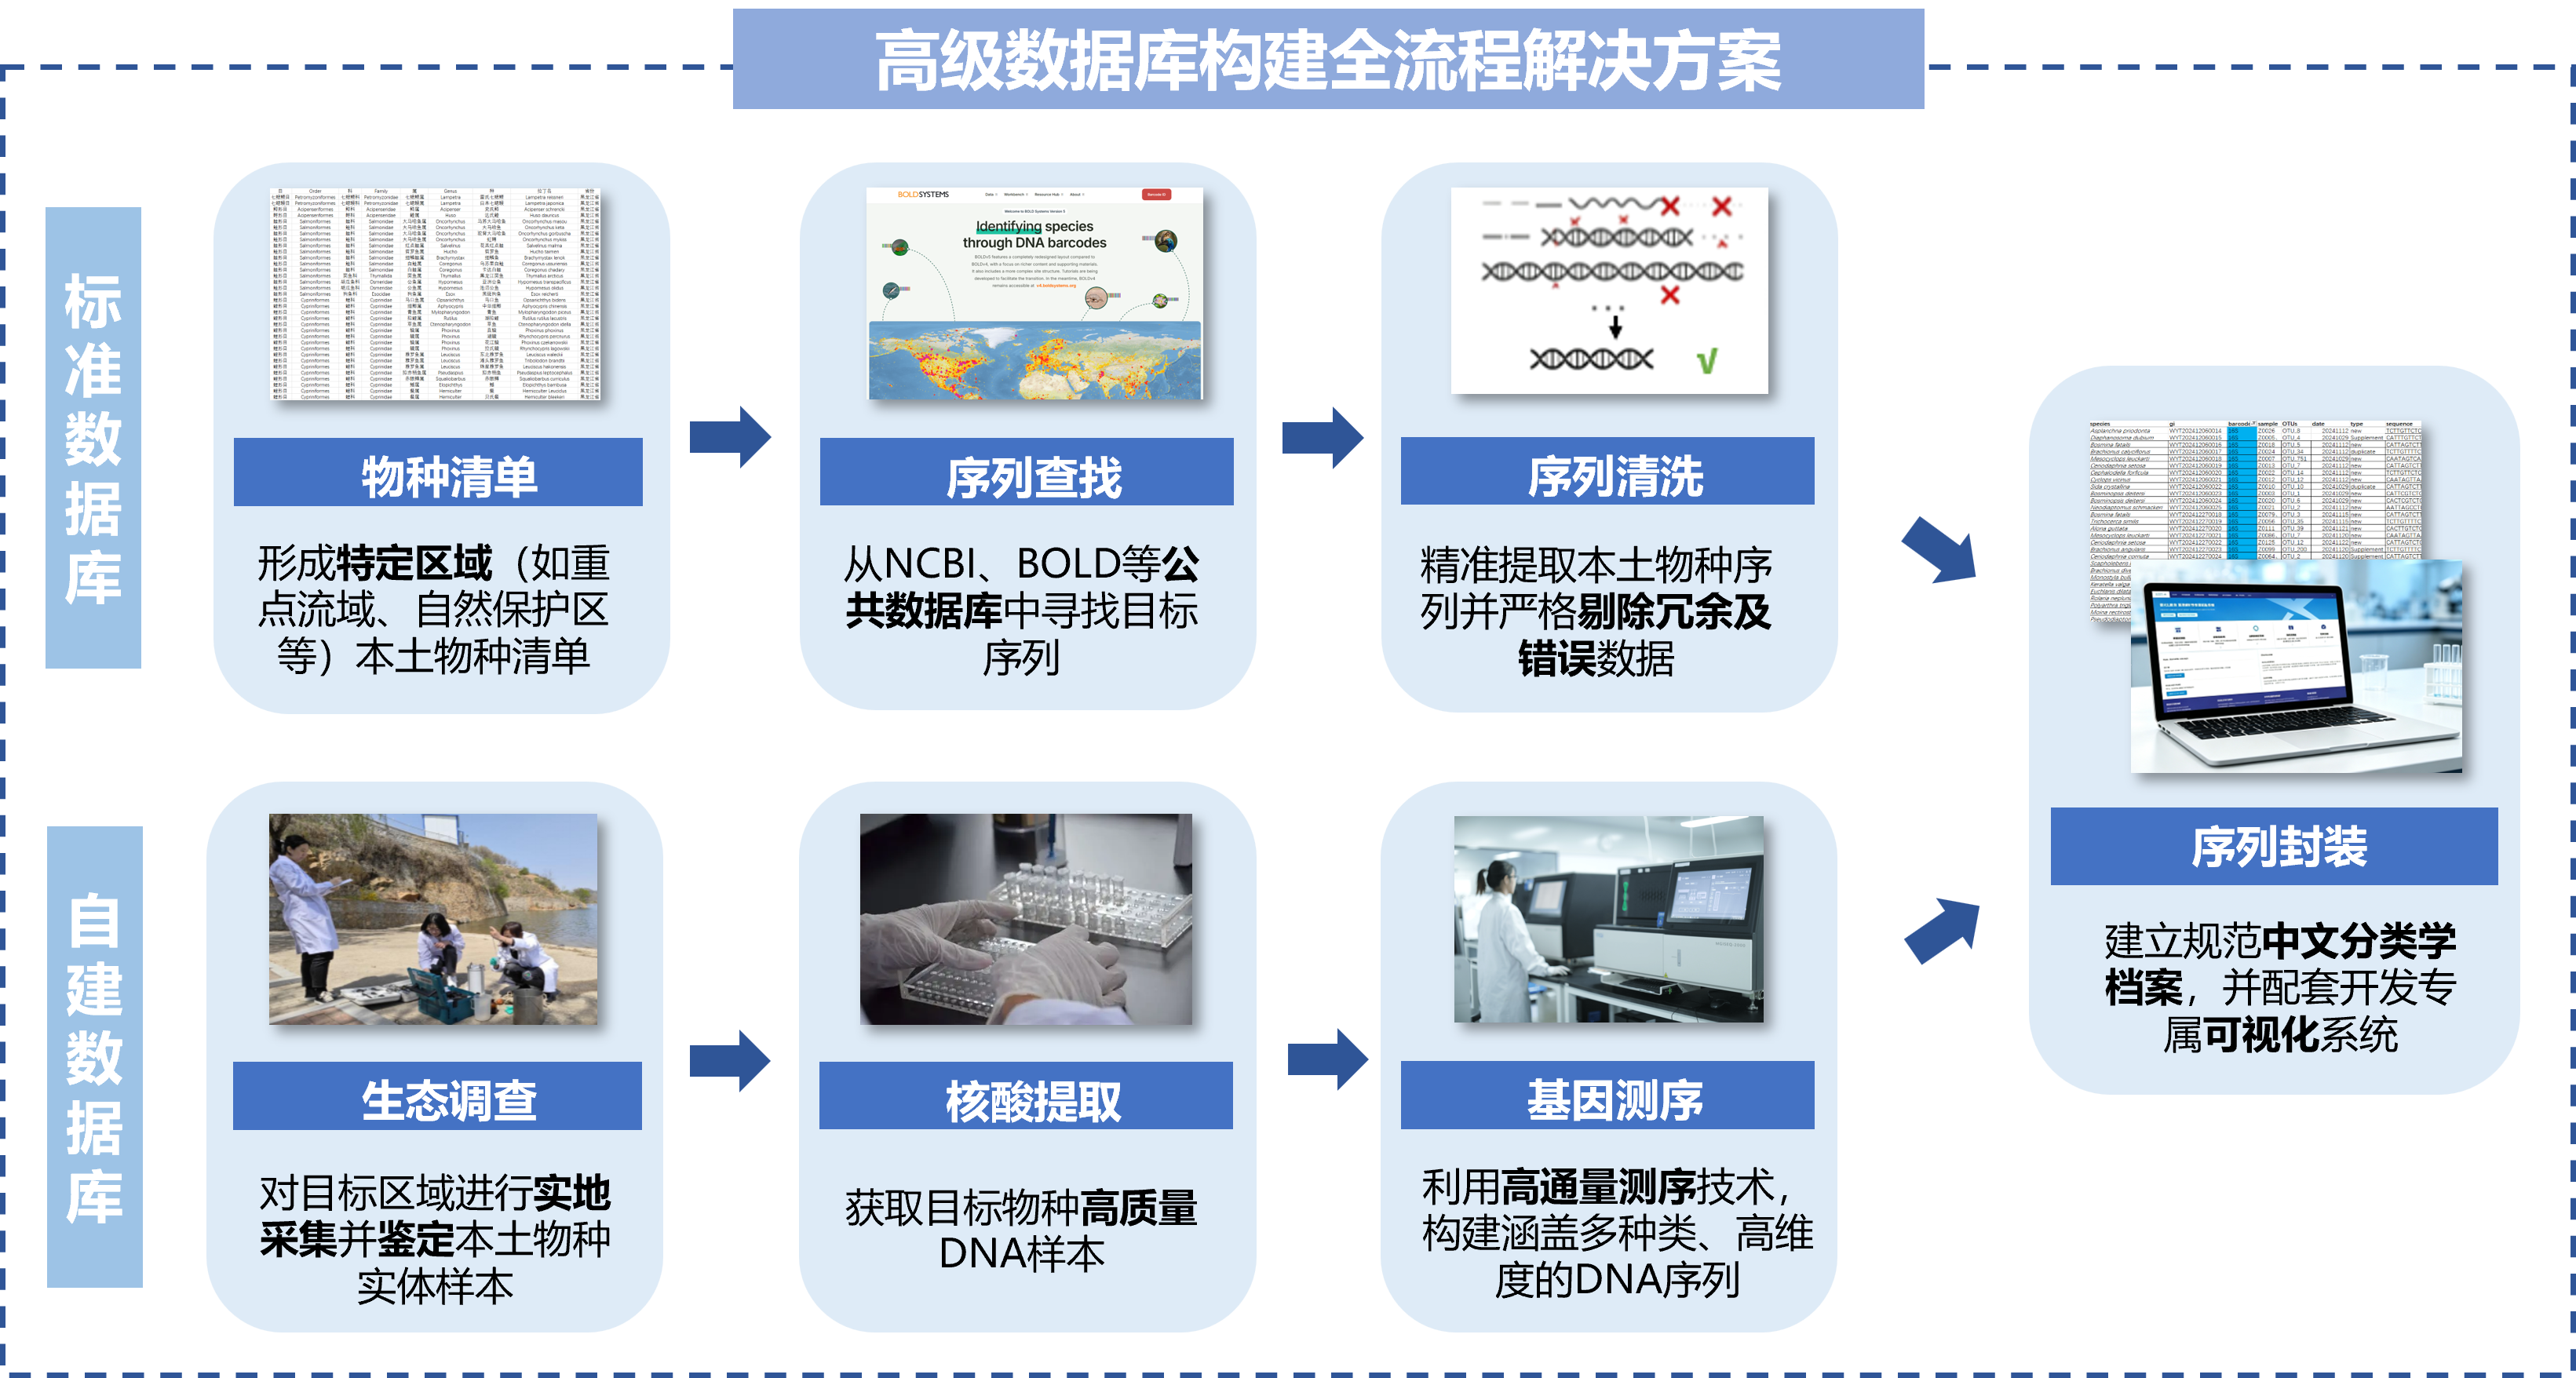
实地调查与从头测序构建在标准版的基础上,通过“实体样本+基因测序”双管齐下,填补公共数据空白,打造最权威的专属数据库。
经典生态调查
深入目标区域开展系统的传统物种本底调查,实地采集并鉴定本土物种实体样本。
多基因从头构建
提取样本核酸,利用二代高通量测序技术进行重测序,从头构建涵盖12S、COI、18S、ITS、Cytb及线粒体全基因组等高维度的DNA条形码序列。
全链条系统交付
同步完成标准版中的引物适配截长、再聚类、中文分类信息建立及管理系统开发,最终交付具备极高溯源性与权威性的完整本土物种数据库。
解决方案优势
去伪存真与定制化
通过实地采样与二代测序“从头构建”多基因条形码,有效填补了公共数据库中本土物种的基因数据空白,保证了数据的权威性与准确性。
区域专属定制
专为特定区域(如流域、自然保护区等)量身定制,排除了无关物种的干扰,构建出真正符合当地生态特征的“本土化”专属数据库。
管理系统化
建立了“统一的中文分类信息”,配套开发了专属的“数据库管理系统”,让复杂的数据管理变得可视化、便捷化。最终交付的数据库可直接无缝对接投入到宏条形码的物种注释工作中。
服务内容
| 序号 | 产品名称 | 引物信息 | 测序方法 |
|---|---|---|---|
| 1 | 藻类(蓝藻+真核) | 16S/18S V4/18S V9 | NGS(1万reads) |
| 2 | 浮游动物 | COI/16S/18S | NGS(1万reads) |
| 3 | 底栖动物 | COI/18S | NGS(1万reads) |
| 4 | 鱼类 | 12S | Sanger测序 |
| 5 | 水生植物 | trnH2/rbcL | NGS(1万reads) |
| 6 | 鸟类 | 12S | Sanger测序 |